
先 完整 完整 阅读文档和代码注释!!!
别忘记点star
项目由来
- 在调用深度学习训练好的AI模型时,如果使用python调用非常简单,甚至不用编写代码,大部分深度学习框架就是python编写的,自带有推理逻辑文件和方法
- 但是不是每个同学都会python,不是每个项目都是python语言开发,不是每个岗位都会深度学习
- 由于大部分服务器项目还是由java语言居多,之前java方向的同学也多,由于找遍全网也没有找到java调用AI模型的例子
- 所以特意编写一个java调用AI模型的方法(全网独这一份,目前市面上出来的java ai的相关项目的底层代码都来源我这个)。思路是通用的,只需要替换不同的模型即可达到不同效果
- 不是收集集成别人的项目,该项目2020年下半年就开始本地开发编写了。初代java ai项目,始祖级别,目前主流的其他开源java ia项目都是基于或内部引用我这个项目的,github上也有很多项目借鉴了这个思路
- 极其轻量,两个依赖,一个java主文件即可运行
- 不懂项目有什么用作?不知道用在什么地方?没关系,先下载运行看效果后立马就明白了!
- 该项目属于底层原理型项目,是底层支撑性的项目,工具类项目,不含任何业务与上层逻辑,可以给其他java spring ai项目提供集成和支撑
- 本来不想说怎么和springboot集成的,思路:先使用@Bean注解将OrtSession封装为单例,然后再@Autowired/@Resource注入使用,文章最后有集成例子 11.项目使用很简单,但是为了更好的使用,建议还是了解一下yolo和onnx的相关知识。便于更好的使用。
环境
- master分支:面向过程写法(便于大家看懂),dp分支:面向对象写法。第一次先运行master分支代码
- 只需要java环境不需要安装其它!JDK大于等于11,不能用1.8。 代码目录不能含有中文!
- maven源记得改为国内源,否则下载依赖需要2天。
- CPU建议i7 12代以上,自己测试可以不用GPU,实际项目必须GPU,尽量3060以上(图片检测无所谓,视频流实时检测必须GPU)
- 本项目相当于最基础工具处理方法,不包含和结合业务逻辑,项目使用时视频流需要多线程,队列等等,需要自己处理。
- 不包含视频流处理以及存储,转发等功能,具体实现搜索关键字:流媒体服务器,rtmp 等等。 思路如下:一个线程拉流,一个或多个线程识别,一个线程推流,一个现成告警,一个共变量存储最新画面防止堆积或者使用多个队列,待识别图像队列,待合成视频队列,告警消息队列等,拉流线程只负责更新最新画面,识别线程只负责识别最新画面,识别后放到队列等待推流线程推流(注意帧率)
紧接着下载运行看效果再研究代码
看不懂代码也要先运行,直接运行不会报错
- 下载代码可直接运行主文件:
CameraDetection.java(优先运行),ObjectDetection_1_25200_n.java,ObjectDetection_n_7.java,ObjectDetection_1_n_8400.java都 可以直接运行不会报错 CameraDetection.java,是实时视频流识别检测,也可直接运行,三个文件完全独立,不互相依赖,如果有GPU帧率会更高,需要开启调用GPU。images目录下有视频文件也可以改为路径预览视频识别效果,根据视频实时识别demo,其他文件都可以改为实时识别- 多个主文件是为了支持不用网络结构的模型,即使是
onnx模型,输出的结果参数也不一样,目前支持三种结构,下面有讲解 - 可以封装为
httpcontrollerapi接口,也可以结合摄像头实时分析视频流,进行识别后预览和告警 - 支持
yolov7,yolov5和yolov8,paddlepaddle,mindspore后处理稍微改一下也可以支持, 代码中自带的onnx模型仅仅为了演示,准确率非常低,实际应用需要自己训练 - 训练出来的模型成为基础模型,可以用于测试。生产环境的模型需要经过模型压缩,量化,剪枝,蒸馏,才可以使用(当然这不是java开发者的工作)。会提升视频华民啊帧率达到60-120帧左右。点击查看:百度压缩模型工具,基础概念,参考文章
- 视频流检测用小模型,接口图片检测用大模型
- 替换
model目录下的onnx模型文件,可以识别检测任何物体(烟火,跌倒,抽烟,安全帽,口罩,人,打架,计数,攀爬,垃圾,开关,状态,分类,农作物,害虫识别,等等),有模型即可 - 模型不是onnx格式怎么办?不要紧张,主流AI框架模型都可以转为onnx格式。怎么转?自己搜!
暂不直接支持输出结果是三个数组参数的模型(因为不常用)
- 但是这种结构模型可以导出为
[1,25200,85]或[n,7]输出结构,然后就可以使用已有代码调用。 - yolov5 :导出onnx时增加参数
inplace=True,simplify=True(ObjectDetection_1_25200_n.java) - yolov7 :导出onnx时增加参数
grid=True,simplify=True(ObjectDetection_1_25200_n.java) 或者grid=True,simplify=True,end2end=True(ObjectDetection_n_7.java)

ONNX
Open Neural Network Exchange(ONNX,开放神经网络交换)格式,是一个用于表示深度学习模型的标准,可使模型在不同框架之间进行转移. 是一种针对机器学习所设计的开放式的文件格式,用于存储训练好的模型。它使得不同的人工智能框架(如Pytorch,TensorFlow,PaddlePaddle,MXNet)可以采用相同格式存储模型数据并交互。 ONNX的规范及代码主要由微软,亚马逊 ,Facebook 和 IBM 等公司共同开发,以开放源代码的方式托管在Github.
图片效果
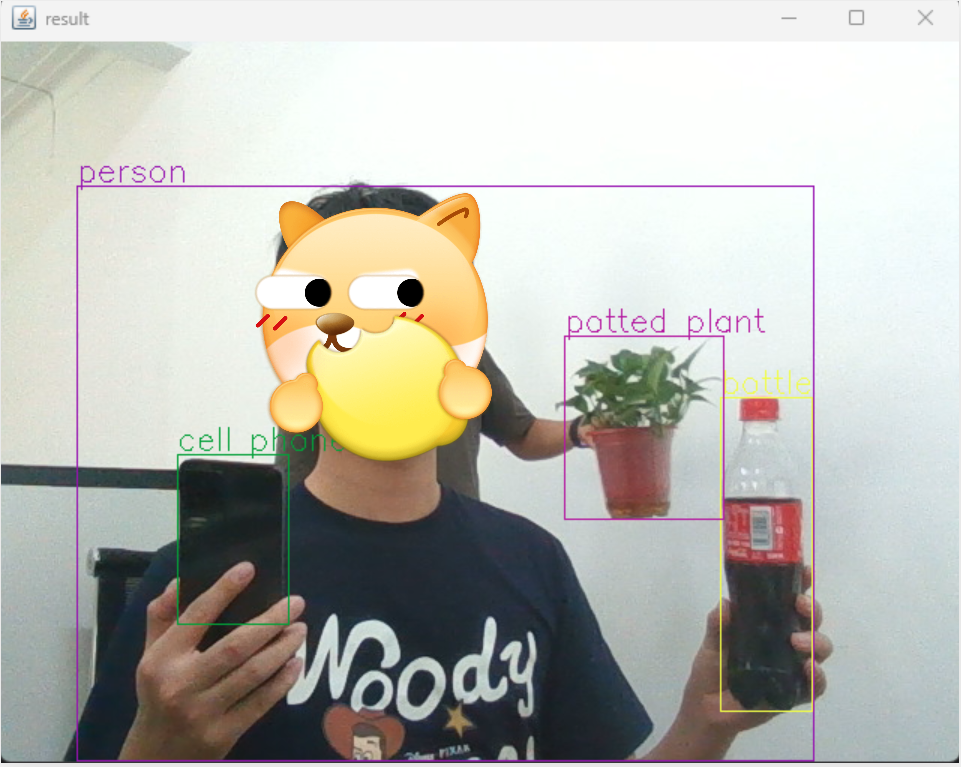


视频效果(必看)
3588 rknn系列加群讨论
扫码加群备注:已完整阅读文档
- 无备注不通过,进群学习看公共告如何训练模型,看完后面文档再加群
- 进群1小时内发运行成功代码截图,不然踢出群,真踢。

有用链接
- https://blog.csdn.net/changzengli/article/details/129182528
- https://blog.csdn.net/xqtt29/article/details/110918397
- https://blog.csdn.net/changzengli/article/details/127904594
- 使用封装后的javacpp中的javacv 和 ffmpeg 也可以
使用GPU前提
-
对于图片处理,不是必须使用GPU,处理视频建议使用
-
更新显卡驱动,显卡驱动一定要最新版本
-
nvidia-smi 显示你的显卡最高支持的cuda,实际以你安装的为准。
-
安装对应版本的:cuda 和 cudnn,版本需要和自己电脑上的GPU型号对应,和项目无关
-
并测试是否安装成功,一定要测试: nvcc -V
-
版本不要高于:cuda11.8,不仅要注意cuda和onnxruntime版本对应关系,还要注意cuda和cudnn版本对应关系,否则报错
-
安装环境要有耐心,初学者可能需要2周左右才能安装好,别着急
中文解决方案


人体姿态姿势动作识别(PoseEstimation.java)
onnx模型文件超过100MB,gitee无法提交,onnx下载地址: https://pan.baidu.com/s/17Ip03WmDZf7JnPNbONDZyw 提取码: 加群获取
用途:姿势,行走,站立,跌倒,奔跑,跳舞,跳绳等等


- 跳绳


旋转目标检测OBB(定位方向,角度,倾斜,摆放等等)


已经集成的Springboot项目
- https://gitee.com/giteeClass/java-vision
- https://gitee.com/qj-zye/java_pytorch_onnx_tensorrt_yolov8_vue
高级算法,加群领取
- 没看文档和没看注释的不能加群
- 3588 入门demo例子
- java onnx 图像分割分割描边抠图(纯java本人手写实现,需要图像分割onnx模型)

- rtmp rtsp 识别后推流流媒体示例

java onnx 目标跟踪(纯java本人手写实现)
- gif比较大,等待一会,不一定是车,可以对任何识别出来的目标进行跟踪
- 目标跟踪:车辆计数,人员计数,车牌识别,人脸识别,等等计数,重复识别,重复报警

- java onnx v8目标分类(已完成)
- 人脸识别已完成